Tokens
Peraí, a IA só prevê tokens?
Quando uma IA te responde, ela não está escrevendo uma frase. Ela está prevendo um pedacinho de texto, depois o próximo, e o próximo. Não a próxima palavra: o próximo token. Previsão por previsão, ela escreve seus e-mails, seu código, suas histórias. Então bora abrir essa caixa-preta: afinal, o que é um token?
Afinal, o que é um token?
Você talvez imagine a IA lendo palavras inteiras, do jeito que você lê. Não é assim. Antes de responder, ela corta o seu texto em pedacinhos chamados tokens.
Um token é um pedaço de texto. Às vezes é uma palavra inteira, tipo "futebol". Às vezes é só parte de uma: "geladeira" vira "gel" e "adeira". Até uma vírgula ou um ponto pode ser um token sozinho.
Por que esses cortes? O tokenizer, a ferramenta que faz a divisão, aprendeu seus pedaços lendo uma quantidade enorme de texto. Palavras comuns costumam ficar inteiras, e as mais longas ou raras são quebradas em partes conhecidas. Uma regra aproximada da OpenAI: um token equivale a uns 3/4 de uma palavra em inglês. Cada família de modelos tem o seu tokenizer, então as contas mudam de um pra outro. O gráfico abaixo usa o do GPT-4o.
- Por
- favor
- ,
- remarque
- minha
- consulta
- no
- dent
- ista
- para
- sexta
- .
Nove palavras viram 12 tokens. "dentista" vira dois pedaços, "dent" e "ista", e a vírgula e o ponto ganham um token cada. O pontinho apagado marca um espaço no começo do token.
De pedaços para números
Computador trabalha com números, não com palavras. Então cada token é trocado por um número, como o número da página num dicionário gigante: na nossa frase, " sexta" é o 54039. Dali em diante, o modelo só enxerga números, e no fim o app transforma tudo de volta em palavras.
Não vamos nos aprofundar nisso, mas é bom saber o que acontece por baixo dos panos.
Uma previsão por vez
Pra escrever uma resposta, o modelo olha todos os tokens até ali e dá uma nota pra cada próximo token possível. Ele escolhe um, coloca no final e repete.
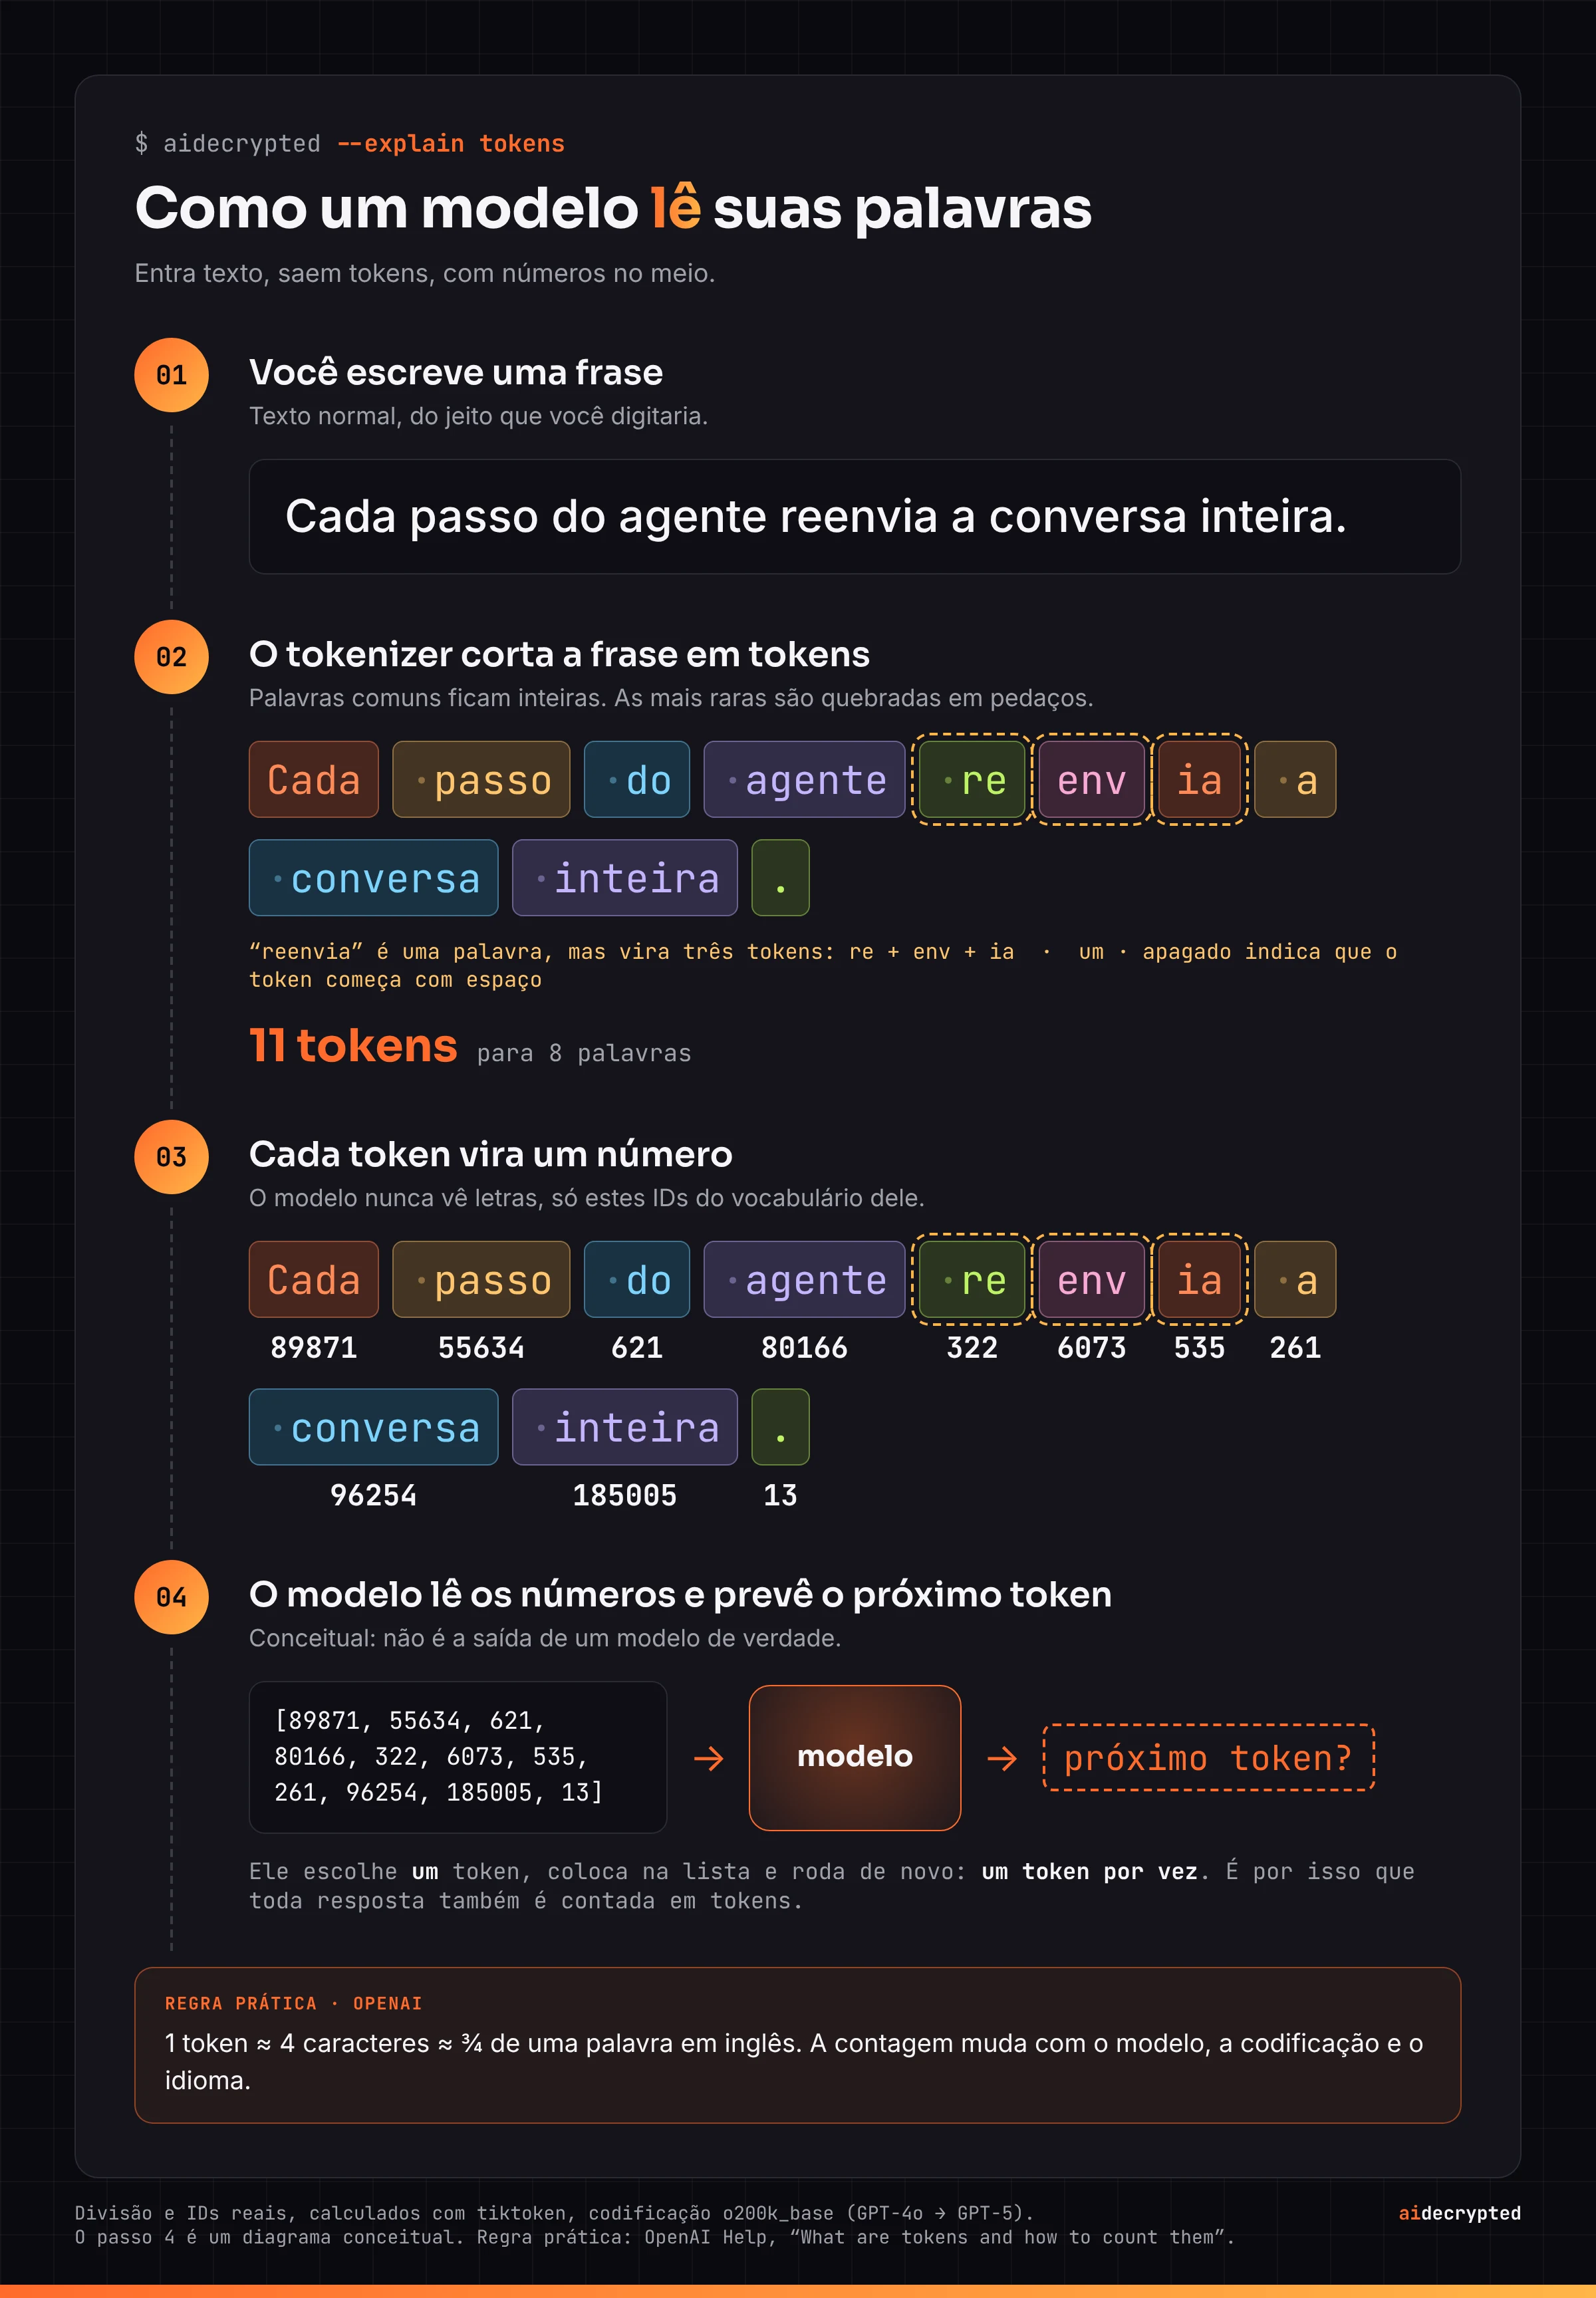
O caminho completo com outra frase: o texto vira tokens, os tokens viram números, e o modelo prevê o que vem depois.
Uma resposta curta leva algumas dezenas desses passos; uma longa, centenas ou milhares. O modelo não planeja a frase inteira de uma vez. Ele prevê o próximo token, depois o seguinte, até chegar num token de parada ou num limite de tamanho.
Por que a IA relê tudo
A IA não lembra da sua conversa. Toda vez que você manda uma mensagem, ela começa do zero, com a cabeça vazia.
Então como ela parece lembrar? O app manda a conversa inteira de novo, toda santa vez. Sua mensagem nova mais tudo o que já foi dito.
Imagine este papo curto:
- Você: "Oi, meu nome é Ana."
- IA: "Prazer, Ana!"
- Você: "Qual é o meu nome?"
Quando você pergunta "Qual é o meu nome?", a IA não se lembra da Ana. Ela recebe as três linhas de novo, lê tudo do começo e acha a resposta ali. Se o app mandasse só a sua última linha, a IA não faria ideia de quem você é.
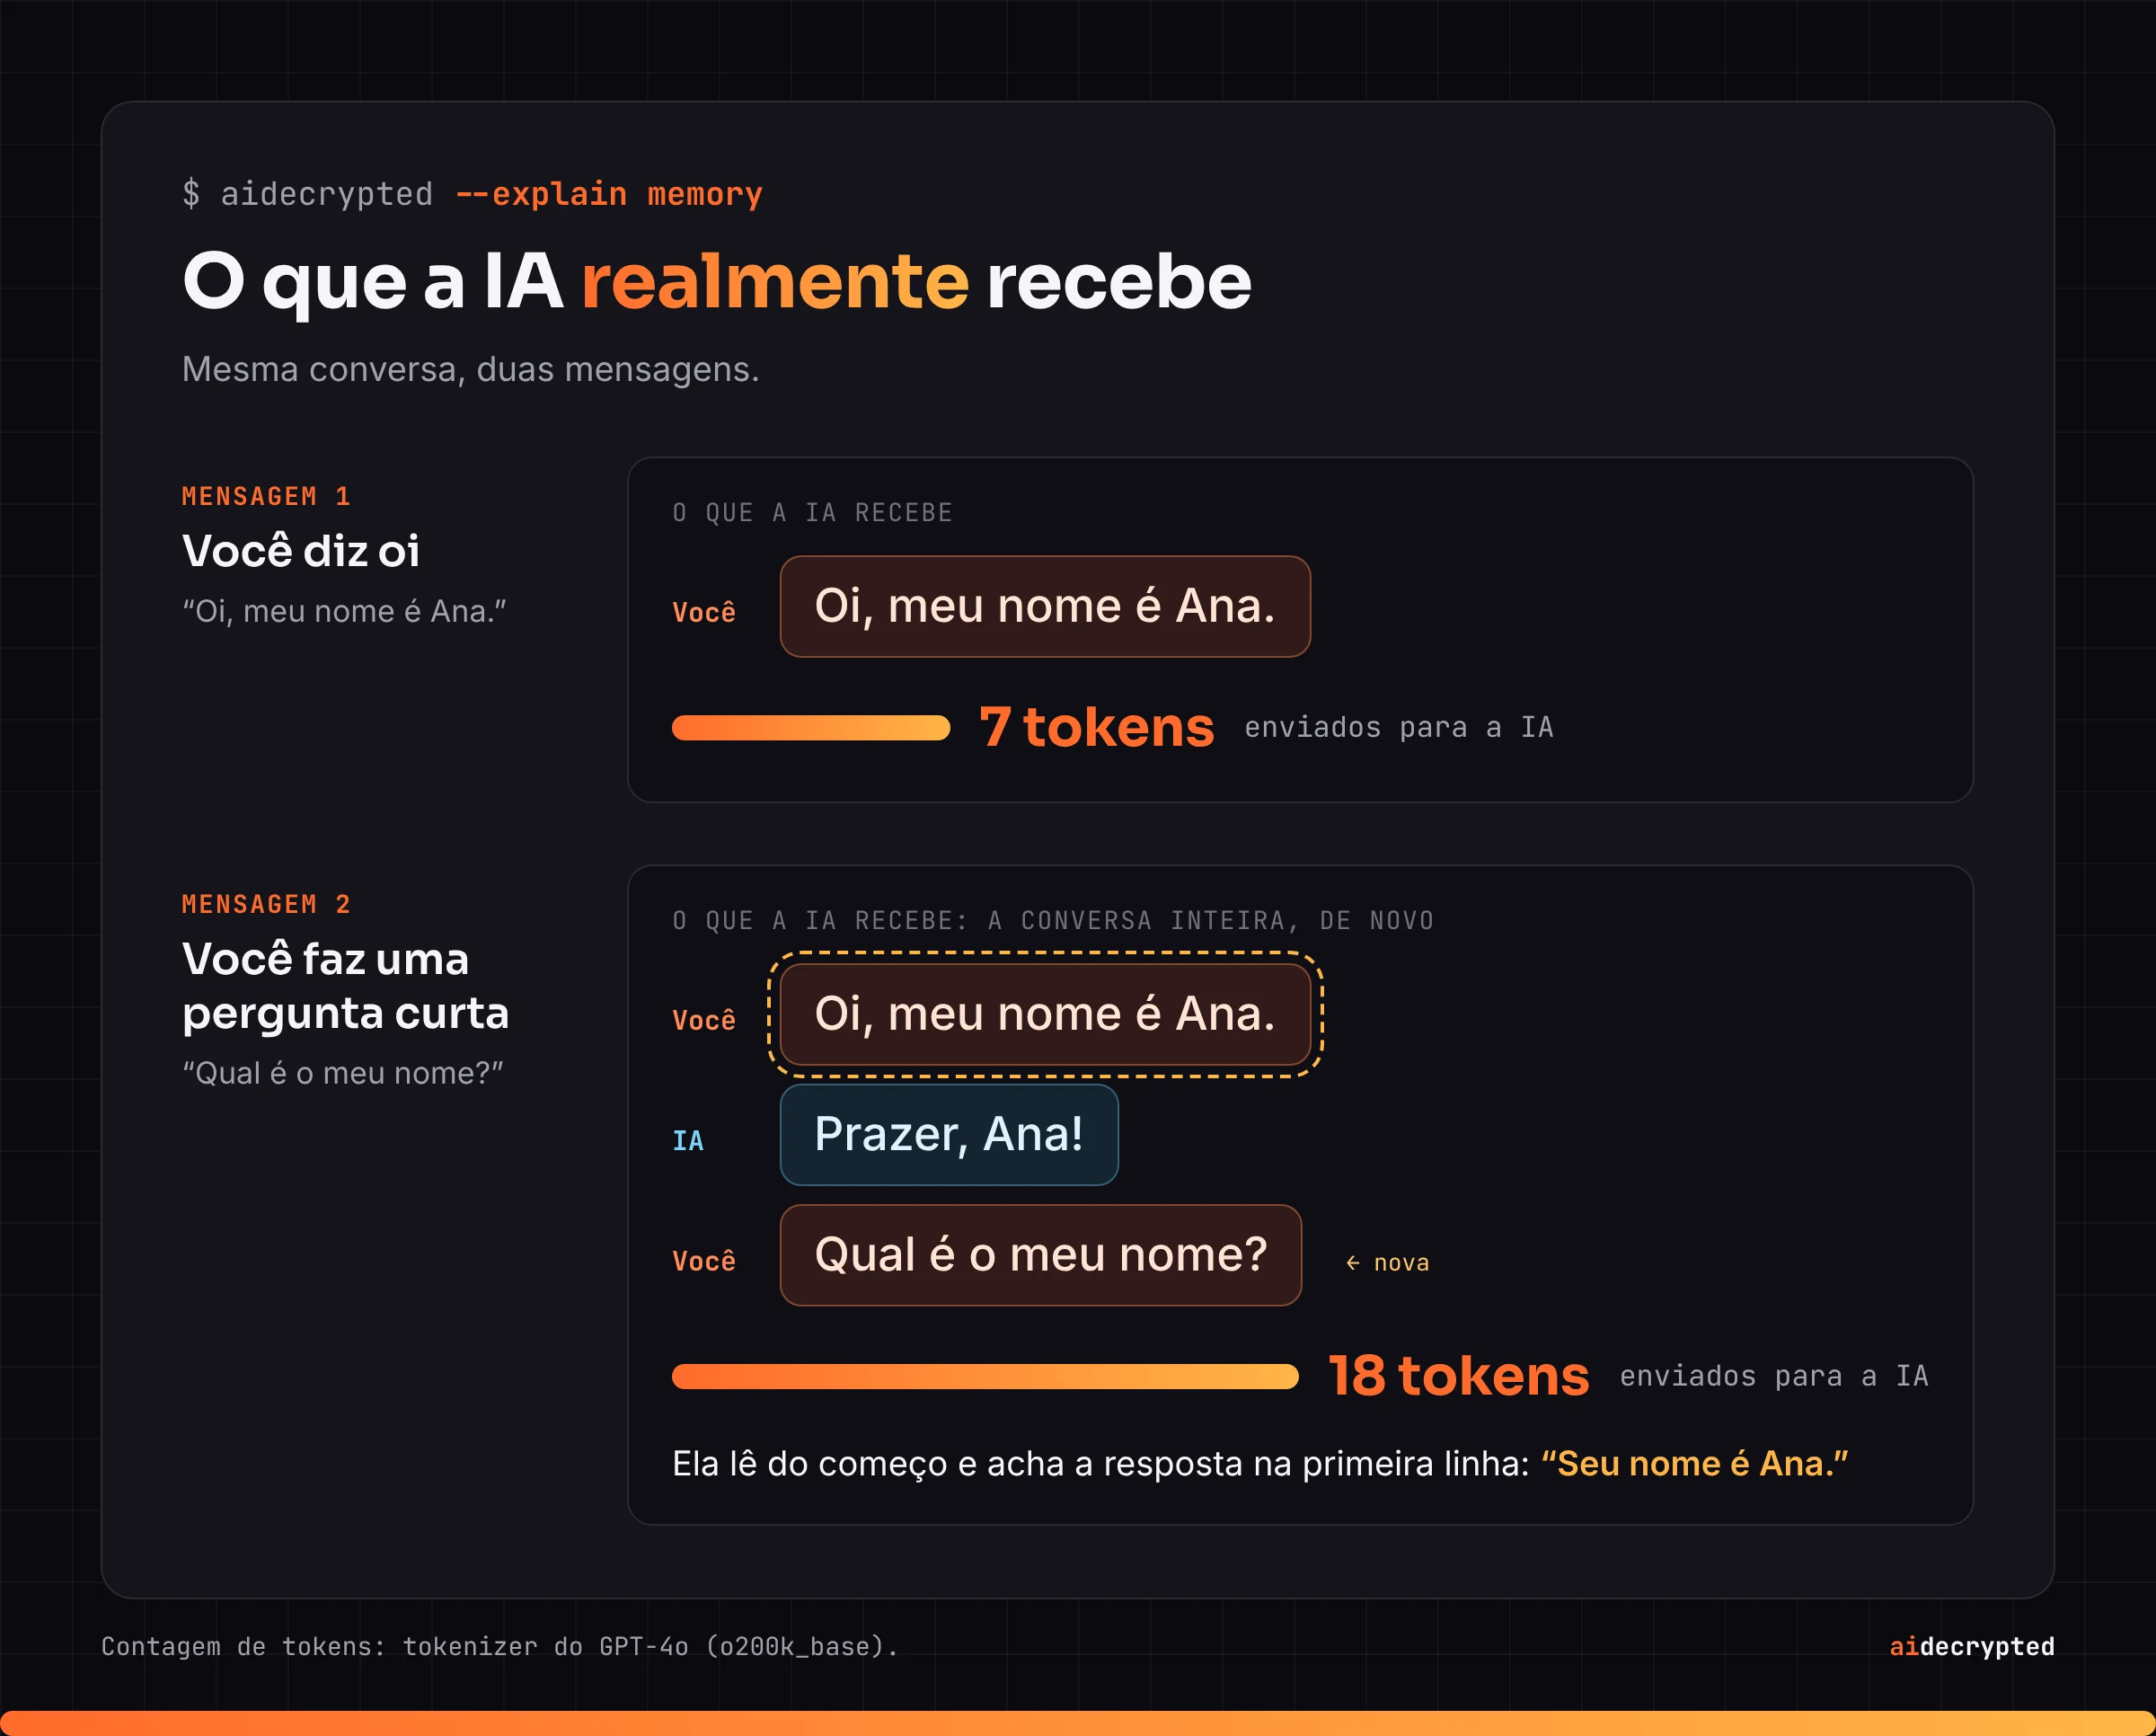
A IA não lembra. O app entrega a conversa inteira toda vez. (As contagens são só do texto das mensagens; apps de verdade também mandam instruções escondidas, então os números reais são maiores.)
Ou seja, cada mensagem deixa a próxima maior. Numa conversa curta, tanto faz. Mas numa conversa longa, ou depois que você cola um artigo enorme, a IA relê tudo a cada rodada, e cada releitura gasta tokens.
O mesmo acontece quando a IA pesquisa na web pra você. As páginas que ela encontra entram na conversa como texto e são relidas em todas as rodadas seguintes, mesmo depois que você já mudou de assunto.
Mas alguns apps de IA tomam notas
Reler tudo não é o único jeito de lembrar. Apps e ferramentas como Claude Code, ChatGPT Codex ou Grok Bot (veja nosso post sobre o Grok Bot) colocam ferramentas extras em volta do modelo, e uma delas é a memória. Você também pode ver isso com o nome de memória de longo prazo ou memória do agente. O Grok Bot funciona assim: cada bot tem a sua própria memória, uma listinha curta de notas. Quando aparece algo importante, o bot anota.
O app entrega ao modelo essa listinha de notas junto com a sua mensagem nova. As notas continuam sendo texto, então continuam gastando tokens, mas meia dúzia de linhas custa bem menos que um histórico inteiro. Conversas longas recebem o mesmo tratamento: as partes mais antigas são resumidas.
O modelo em si continua sem lembrar de nada. A memória fica no app, que escolhe as poucas linhas que valem a pena mandar.
O que é um "pool de uso", ou cota
Por muito tempo, os planos de IA eram vendidos por quantidade de mensagens: um número fixo de conversas a cada poucas horas, e depois você espera. Cada vez mais planos agora te dão uma cota de tokens, que normalmente recarrega toda semana. Essa cota é o seu pool de uso.
A maioria das empresas não diz exatamente quantos tokens tem no pool.
Empresas muitas vezes pagam sob demanda. Imagine cinco funcionários dividindo uma conta: cada token que eles usam é contado, e a empresa recebe uma fatura só no fim do mês. Sob demanda, você paga um preço por milhão de tokens, e esse preço depende do modelo:
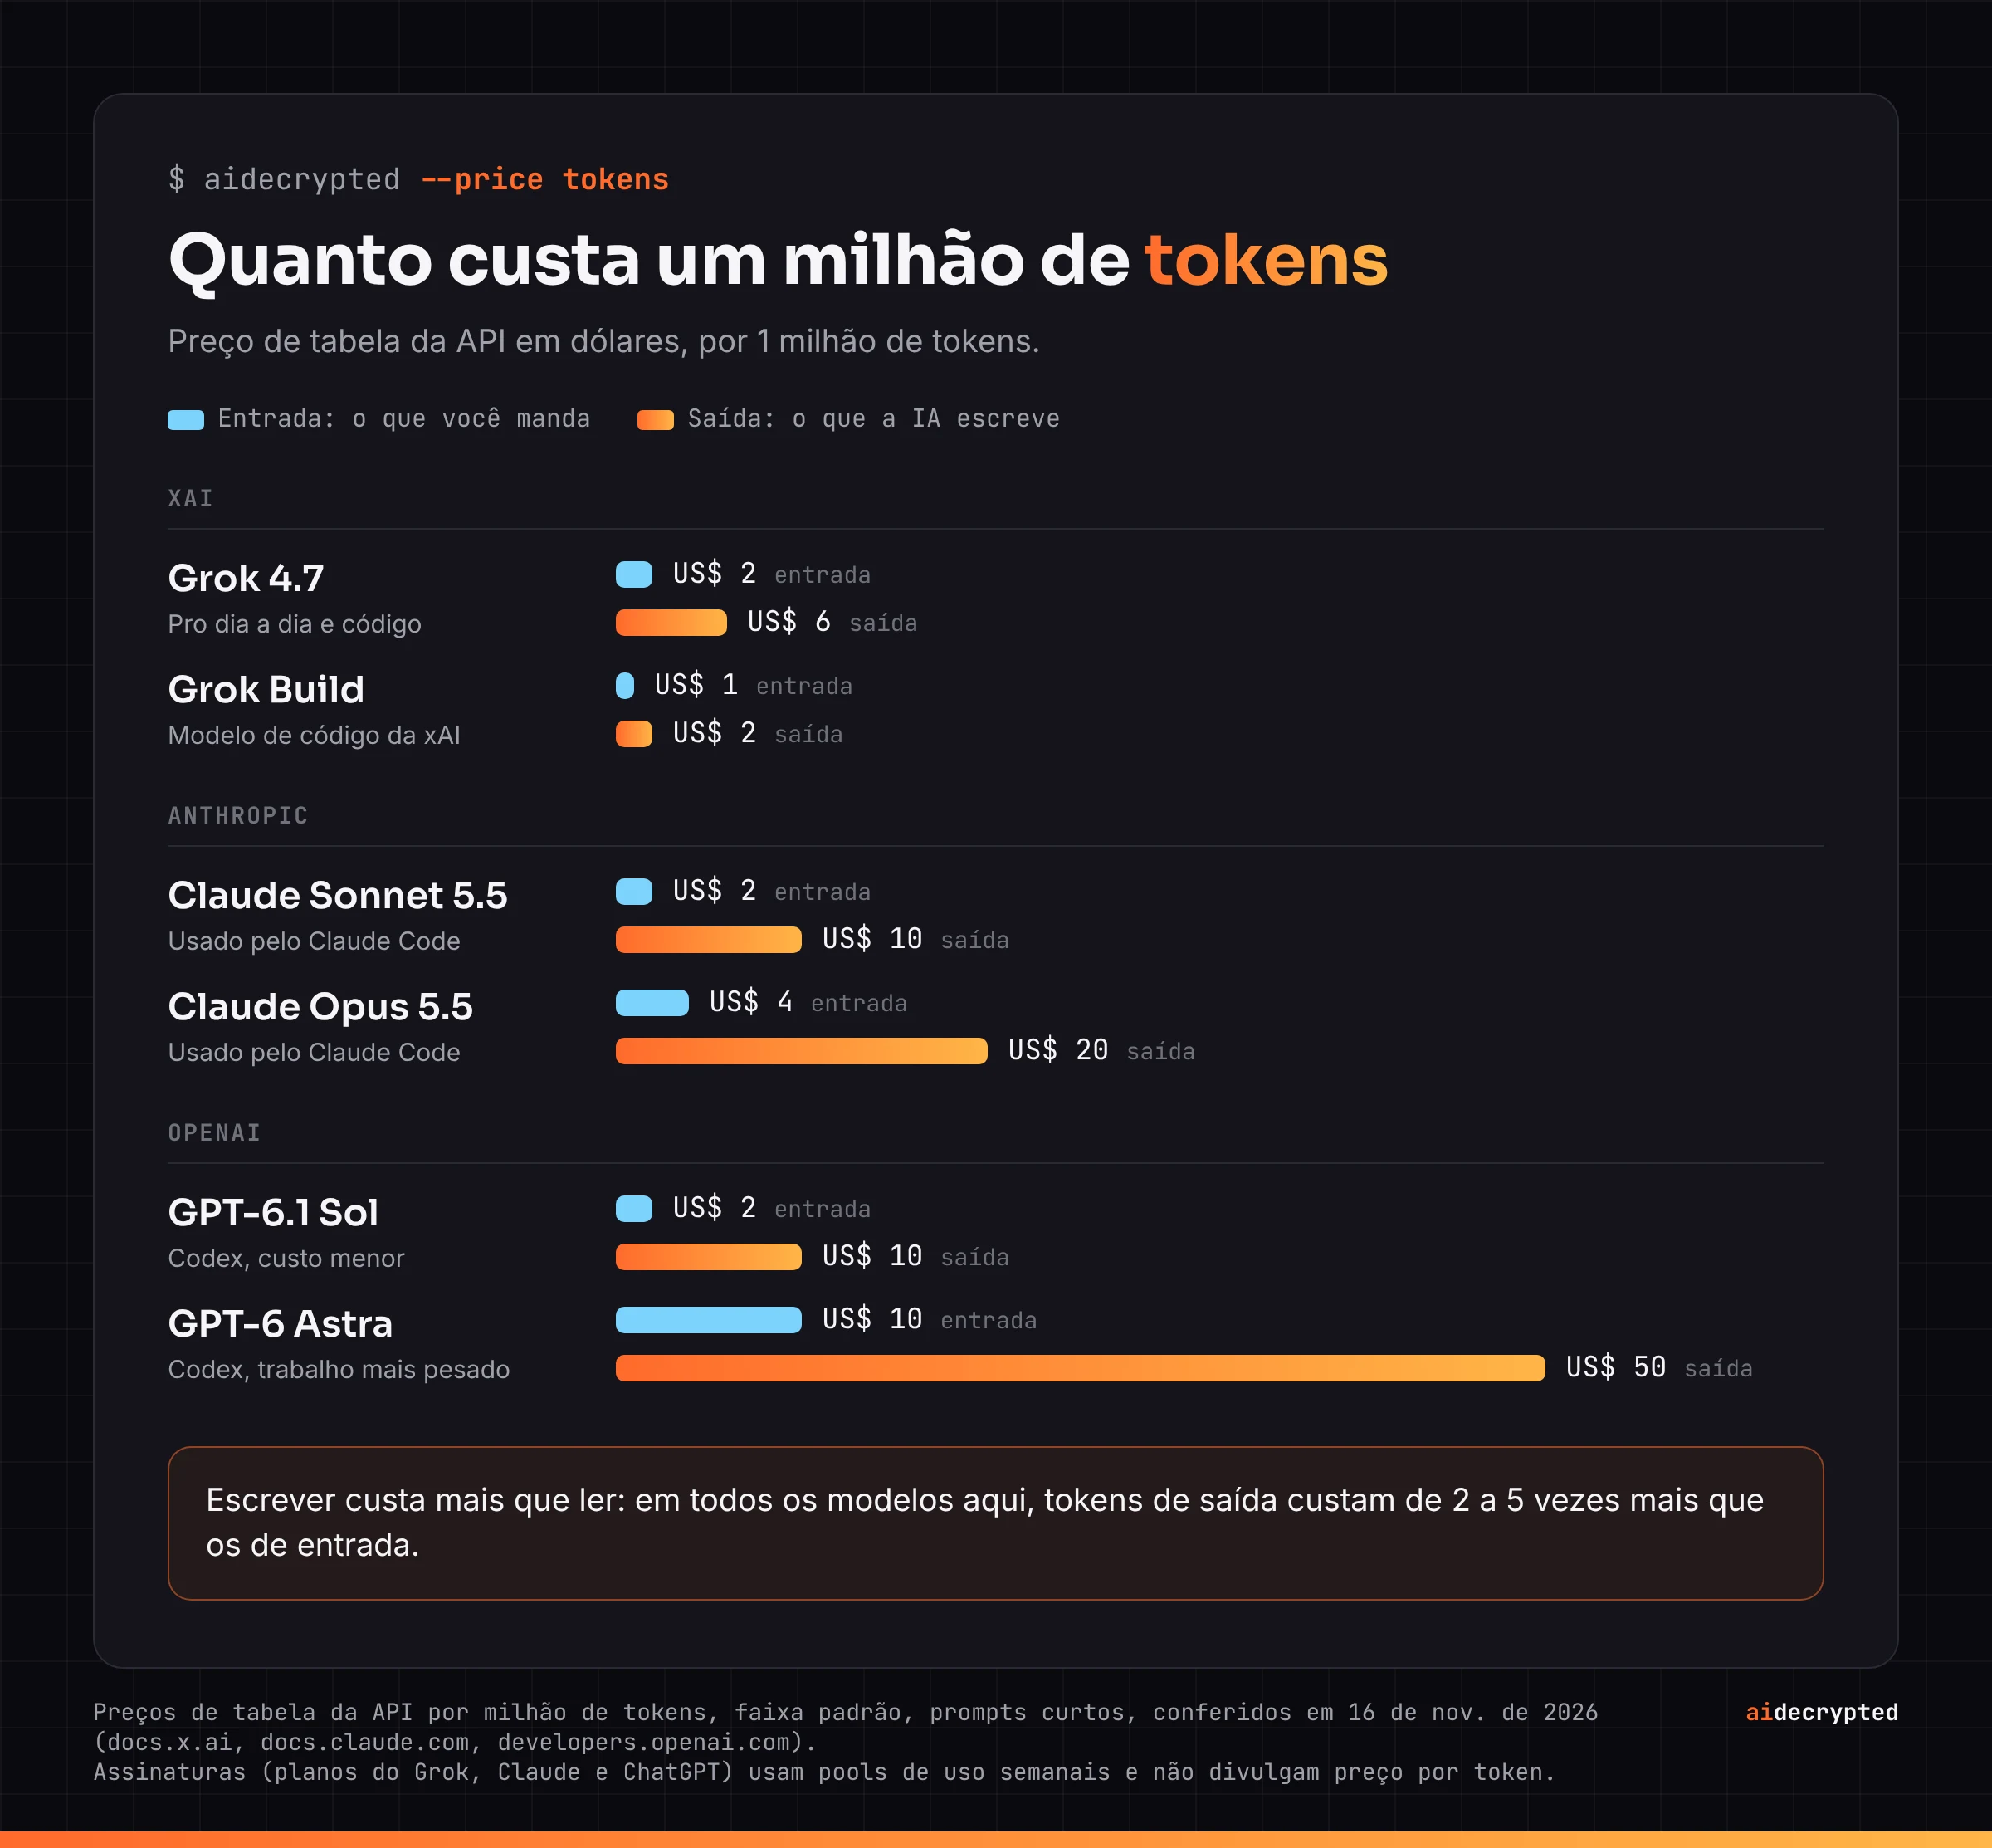
Preços de tabela da API por milhão de tokens, faixa padrão, conferidos em 16 de novembro de 2026. Escrever custa mais que ler: tokens de saída custam de 2 a 5 vezes mais que os de entrada.
Com pool ou com fatura, a conta é a mesma. Uma pergunta rápida gasta poucos tokens. Uma conversa longa, uma tarefa de código ou uma pesquisa na web gasta muito mais.
O pool muitas vezes é compartilhado entre os apps da mesma empresa. Nos planos pagos do Grok, chat, imagens, voz, Grok Bot e Cursor puxam todos do mesmo pool semanal (preços da x.ai). O Claude faz o mesmo com o chat e o Claude Code (ajuda do Claude), e a OpenAI diz que o ChatGPT e o Codex vão dividir uma única cota baseada em tokens a partir de dezembro (ajuda da OpenAI).
Por isso duas pessoas no mesmo plano podem estourar o limite em velocidades bem diferentes. O que pesa não é quantas mensagens você manda. É quanto texto a IA precisa ler e escrever pra você.
Como a IA parece tão inteligente se ela só prevê o próximo token?
Uma IA só sabe o que aprendeu até o dia em que o treinamento dela terminou. Então, pra qualquer coisa mais recente, ela usa ferramentas, como uma pesquisa na web. Ela continua só escrevendo tokens, mas em vez de prever a resposta de cabeça, pode escrever um pedido: "pesquise isso na web".
Digamos que você pergunte: "O Guns N' Roses vai tocar no Rio este ano?"
- A IA escreve um pedido de pesquisa em vez de responder de cabeça.
- O app faz a pesquisa e coloca os resultados na conversa, como texto.
- A IA lê os resultados e responde: "Não. O show deles no Rio, marcado para 10 de abril, foi cancelado."
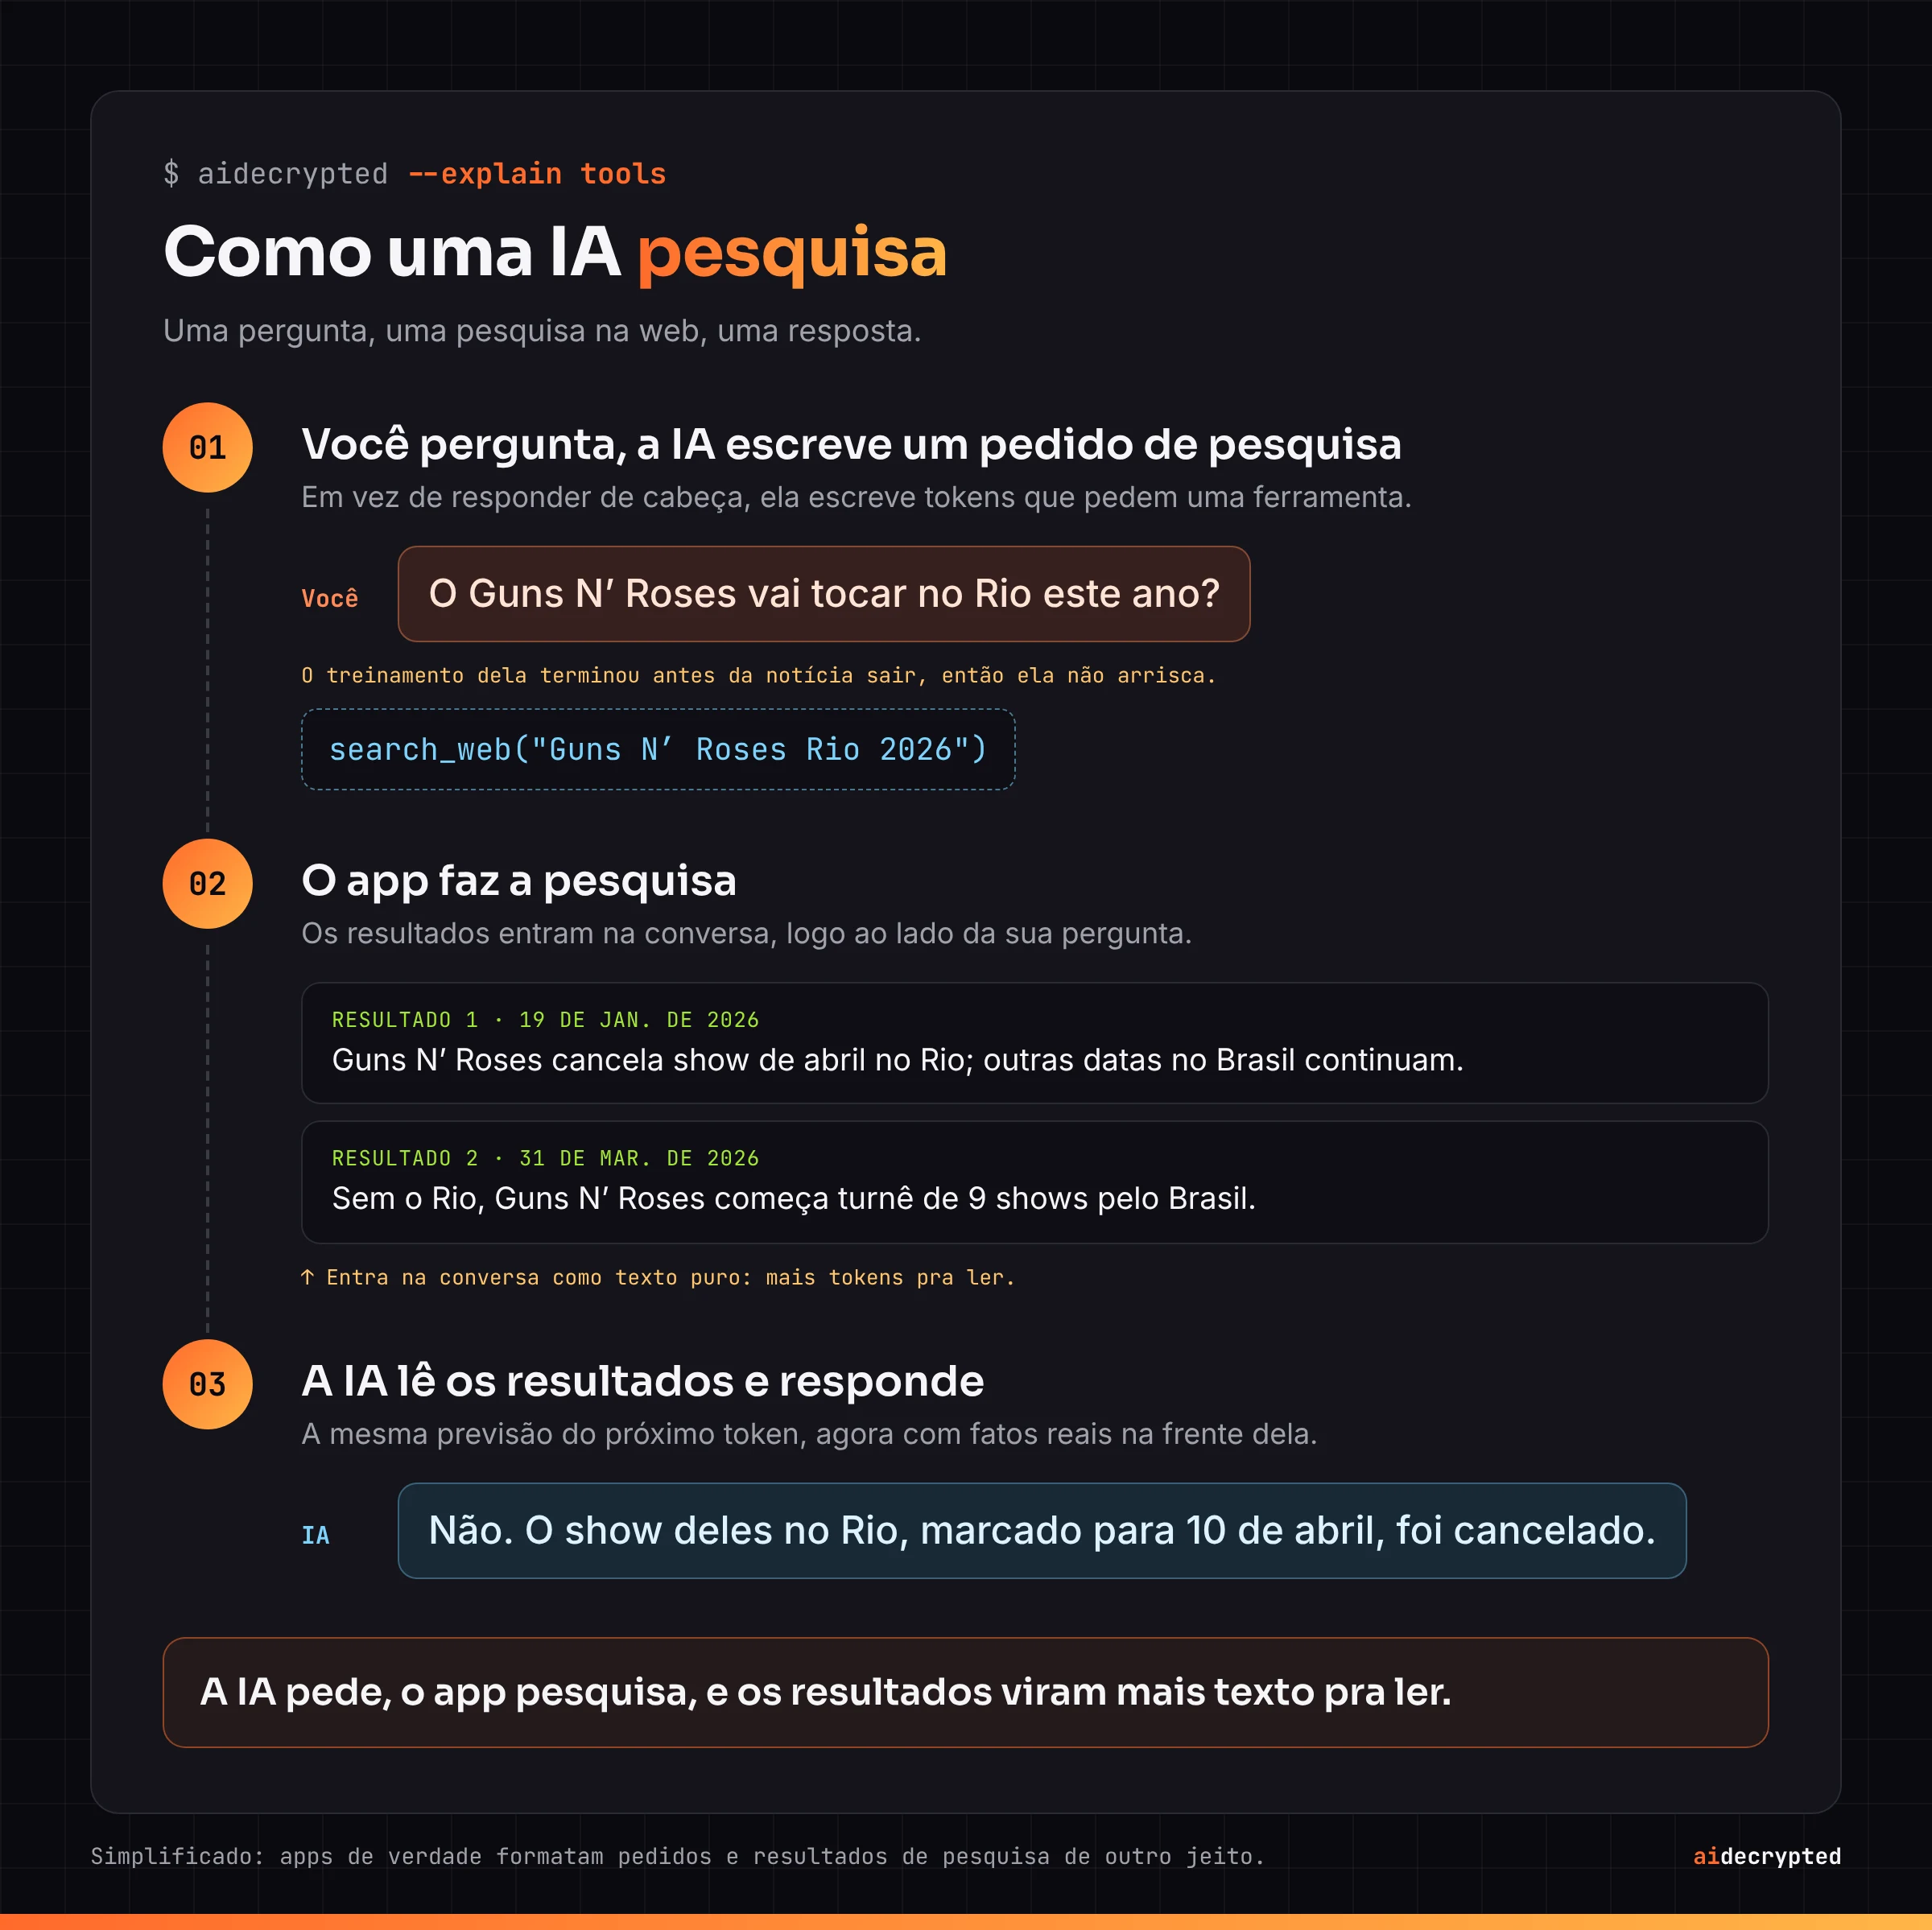
A IA pede, o app pesquisa, e os resultados viram mais texto pra ler.
Tudo o que a IA lê antes de responder (suas mensagens, a conversa até ali e os resultados de pesquisa) se chama contexto. A pesquisa não deixou o modelo mais inteligente. Ela colocou fatos novos no contexto, e o modelo respondeu a partir deles. Sem a pesquisa, ele poderia ter dito que sim, porque o show tinha sido anunciado meses antes.
O que a gente aprendeu
- A IA lê e escreve em tokens, pedacinhos de texto, e cada token vira um número.
- Ela escreve a resposta um token por vez, sempre prevendo o próximo.
- Ela não lembra da sua conversa. O app manda a conversa inteira de novo a cada rodada, então conversas longas gastam mais tokens.
- Alguns apps têm memória: uma listinha de notas que o app manda no lugar do histórico inteiro.
- Cada vez mais planos contam tokens, não mensagens, e escrever custa mais que ler.
- Ferramentas como a pesquisa na web colocam fatos novos no contexto, então a IA consegue responder com informação atualizada.